
Un estudio académico acaba de confirmar algo que cualquier pyme que opera un bot de WhatsApp en Chile ya sospechaba: los modelos de IA más usados no distinguen bien el español chileno y tienden a producir rasgos del español rioplatense. La investigación, liderada por la lingüista Marina Mayor-Rocher de la Universidad Autónoma de Madrid, evaluó nueve modelos de lenguaje en siete variedades del español y el hallazgo se viralizó esta semana en medios chilenos. Si tu bot de atención al cliente o ventas suena como si hubiera nacido en Buenos Aires, no es casualidad ni un bug menor: es un patrón medible y documentado.
Qué midió el estudio y qué resultó para Chile
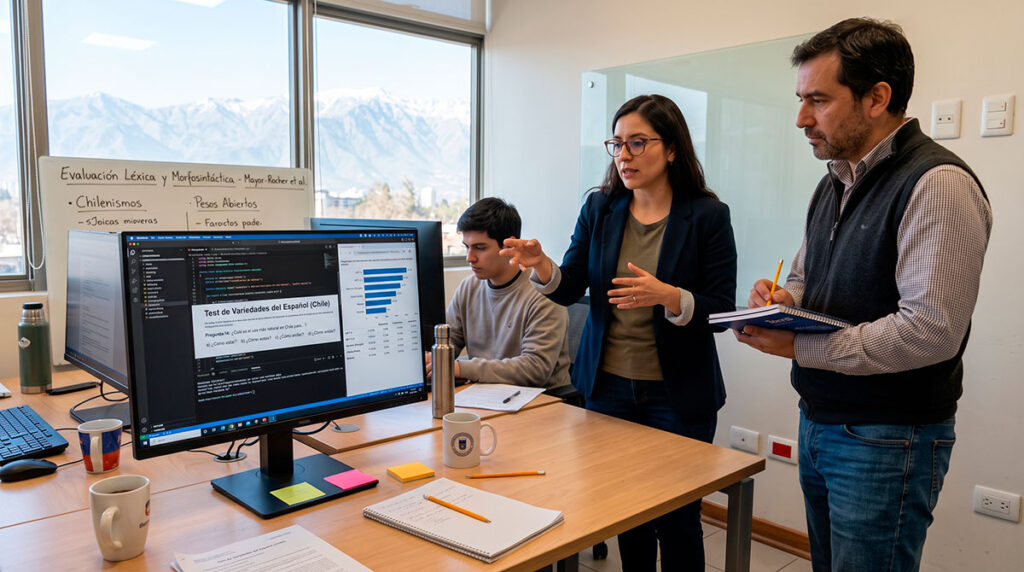
El equipo de Mayor-Rocher diseñó un test de 30 preguntas de opción múltiple para evaluar si los modelos reconocían rasgos léxicos y morfosintácticos propios de cada variedad del español. Los autores evaluaron nueve modelos: dos de OpenAI (ChatGPT) y siete de pesos abiertos, entre ellos Gemma de Google, Llama de Meta y Mistral. Una de las pruebas más simples pedía a los modelos responder “como hablante nativo” de Chile, con preguntas como cómo se le dice de forma familiar a un amigo o cómo se llama el tubo para sorber una bebida. Casi todos fallaron con “weón” y “bombilla”, dos palabras que cualquier chileno resuelve sin pensar.
El contraste regional es elocuente: el español de España fue el mejor reconocido y los resultados se relacionan con la cantidad de texto disponible de cada variedad. Para el chileno, la mayoría no detectó los chilenismos, como “weón” o “bombilla”, ni las marcas regionales en el uso de los pronombres, y algunos modelos pequeños fallaron hasta en el 80% de las preguntas de léxico chileno. El estudio original, publicado bajo el título “Es igual pero no es lo mismo: ¿Distinguen los LLMs las variedades del español?”, precisa además que entre todos los modelos, GPT-4o obtuvo los mejores resultados generales, aunque ningún sistema resolvió el español chileno con solvencia comparable a la del peninsular.
El sesgo lingüístico digital: por qué pasa esto
La explicación no es misteriosa ni tiene que ver con una supuesta preferencia de las empresas de IA por Argentina. Es un problema de datos de entrenamiento. Los modelos aprenden patrones estadísticos a partir de enormes volúmenes de texto disponibles en internet, y el español rioplatense y el peninsular tienen muchísima más presencia digital —medios, foros, literatura digitalizada, redes sociales— que el chileno. Este desequilibrio se conoce como sesgo lingüístico digital, un concepto que describe cómo las variedades con menor huella textual en línea quedan subrepresentadas en los modelos masivos de lenguaje, lo que se traduce en errores sistemáticos cuando el usuario espera una respuesta “nativa”.
El fenómeno no se limita al léxico. Otro estudio reciente de investigadores chilenos, centrado en sesgos de opinión pública, encontró que los modelos representan mucho mejor la opinión pública estadounidense que la chilena, y que los modelos de IA actúan como un espejo de esa cultura, omitiendo las sutilezas políticas, sociales y culturales de naciones como Chile. No es un problema aislado de acento: es una brecha estructural de representación de datos que afecta tanto la forma como el contenido de lo que responde un bot.
Por qué esto le cuesta plata a tu pyme
Para una empresa de retail, servicios o e-commerce que atiende por WhatsApp, un bot que confunde a un chileno con un argentino no es un detalle simpático: es una falla de experiencia que erosiona confianza. Si un cliente pregunta por “la bombilla” de un termo y el bot responde con “pajita” o “sorbete”, el mensaje llega distorsionado. Si el bot usa “vos” en vez del “tú” o el voseo chileno informal, o convierte un “cachai” en un “¿viste?”, el usuario percibe de inmediato que está hablando con un sistema genérico, no con una marca que lo entiende. En contextos de venta o soporte, ese desajuste lingüístico se traduce en abandono de conversación, tickets mal resueltos o directamente en pérdida de la venta.
Checklist de prompting para forzar registro chileno
Antes de evaluar un cambio de modelo, la mayoría de los problemas se puede mitigar —no siempre eliminar del todo— con ingeniería de prompts disciplinada:
- System prompt con ejemplos reales: no basta con decir “responde en español chileno”. Incluye 5 a 10 ejemplos de pares pregunta-respuesta con el registro, los modismos y el tratamiento (tú/usted) que tu marca quiere usar.
- Lista explícita de modismos permitidos y prohibidos: define qué chilenismos son aceptables en tu tono de marca (por ejemplo “al tiro”, “cachai”) y cuáles términos rioplatenses o mexicanos deben bloquearse (“vos”, “che”, “ahorita”).
- Fijar pronombres y formas verbales: especifica si el bot debe usar “tú” formal-cercano o voseo chileno informal, porque los modelos tienden a mezclar pronombres entre variedades sin que se note a simple vista.
- Pruebas de regresión antes de lanzar: arma un set de 20-30 preguntas típicas de tus clientes y revisa manualmente cada respuesta buscando intrusiones de otras variedades antes de escalar el bot a producción.
- Revisión periódica: los modelos se actualizan sin aviso y el comportamiento puede cambiar; lo que funcionó hace tres meses puede fallar hoy.
Cuándo el prompting no basta: alternativas entrenadas en Chile
Si el prompting no logra estabilizar el registro —algo común en interacciones largas o en modelos de voz—, existen alternativas entrenadas específicamente con datos locales. PatagonIA es una familia de modelos especializados impulsada por el Instituto Sistemas Complejos de Ingeniería (ISCI) y WideLabs, con apoyo de Oracle y NVIDIA, que incluye un modelo de texto, uno de visión y un modelo de voz llamado “Coipo” adaptado al español chileno y sus acentos regionales. En paralelo, CENIA lanzó Latam-GPT, el primer modelo de lenguaje abierto entrenado con datos latinoamericanos, que busca reducir brechas históricas en IA y fortalecer la soberanía tecnológica regional.
Aquí el llamado es a la cautela propia de este medio: que un modelo sea “chileno” o “latinoamericano” de origen no garantiza automáticamente mejor desempeño que un modelo general bien ajustado con prompting. Evaluaciones independientes recientes muestran que, pese a su especialización, modelos como PatagonIA no siempre superan a modelos generales de tamaño medio en pruebas comparativas. La recomendación práctica es probar ambas rutas —prompting agresivo sobre un modelo general versus un modelo local— con el mismo set de preguntas antes de decidir.
Cómo testear el bot de WhatsApp antes de escalarlo
Para una pyme que opera o está por lanzar un agente de IA en WhatsApp, el proceso de validación debería ocurrir en un ambiente de prueba separado del canal real de clientes. Un flujo razonable: define los 20-30 mensajes más frecuentes que recibe tu negocio (consultas de stock, reclamos, agendamiento), ejecútalos contra el bot en modo sandbox, y haz que una persona chilena —no el mismo equipo técnico que configuró el prompt— revise cada respuesta buscando intrusiones de otras variedades de español. Si usas una plataforma de agentes para WhatsApp, revisa qué modelo corre por debajo y si permite ajustar el system prompt con el nivel de detalle descrito arriba; las opciones disponibles en Chile incluyen tanto integraciones vía API oficial como configuraciones con herramientas de automatización, y la elección entre una u otra afecta directamente cuánto control tienes sobre el registro lingüístico del bot.
Solo después de superar esa validación manual —sin errores de léxico evidentes ni mezcla de pronombres— tiene sentido escalar el bot a producción y monitorear las conversaciones reales durante las primeras semanas, porque el comportamiento del modelo puede variar con actualizaciones silenciosas del proveedor.