
Fundamentos
- Inteligencia artificial (IA). Campo de la informática dedicado a crear sistemas capaces de realizar tareas que asociamos con la inteligencia humana: razonar, reconocer patrones, entender lenguaje o tomar decisiones.
- Aprendizaje automático (machine learning). Rama de la IA en la que un sistema aprende reglas a partir de ejemplos, en lugar de recibirlas programadas una por una.
- Aprendizaje profundo (deep learning). Tipo de aprendizaje automático que usa redes neuronales con muchas capas. Es la técnica detrás de casi todos los sistemas de IA actuales.
- Red neuronal. Estructura matemática formada por capas de unidades conectadas entre sí, inspirada de forma muy libre en las neuronas del cerebro. Cada conexión tiene un peso que se ajusta durante el entrenamiento.
- Procesamiento del lenguaje natural (PLN). Área que se ocupa de que las máquinas interpreten y produzcan lenguaje humano: traducir, resumir, clasificar textos, conversar.
- IA generativa. Sistemas que producen contenido nuevo (texto, imágenes, audio, código, video) en lugar de limitarse a clasificar o predecir datos existentes.
Cómo funcionan los modelos
- Modelo de lenguaje grande (LLM). Modelo entrenado con enormes cantidades de texto para predecir qué viene a continuación en una secuencia. De esa capacidad surgen la conversación, la redacción y el razonamiento aparente.
- Transformer. Arquitectura de red neuronal presentada en 2017 que permite procesar una secuencia completa en paralelo y ponderar la importancia de cada parte. Es la base de la mayoría de los LLM.
- Parámetros. Los valores numéricos internos que el modelo ajusta al entrenarse y que guardan lo aprendido. Se cuentan en miles de millones.
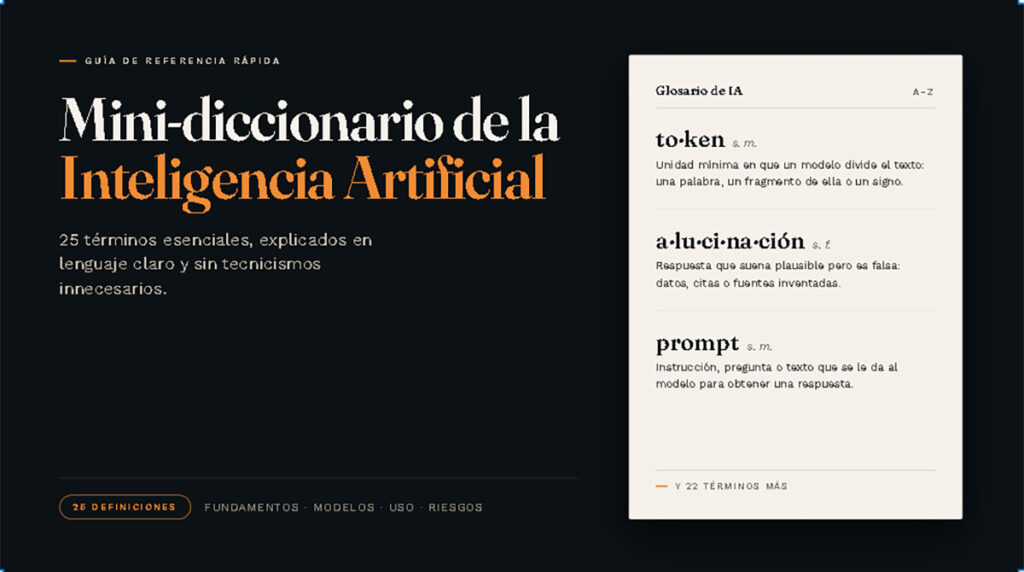
- Token. Unidad mínima en que un modelo divide el texto: puede ser una palabra, un fragmento de palabra o un signo de puntuación. El modelo no lee letras ni palabras, lee tokens.
- Embedding (vector de representación). Traducción de una palabra, frase o imagen a una lista de números que captura su significado. Contenidos parecidos quedan cerca en ese espacio numérico.
- Entrenamiento (preentrenamiento). Fase en la que el modelo procesa grandes volúmenes de datos y ajusta sus parámetros. Es la etapa más costosa en tiempo y cómputo.
- Ajuste fino (fine-tuning). Entrenamiento adicional de un modelo ya preentrenado con datos específicos, para especializarlo en un dominio, un estilo o una tarea.
- RLHF (aprendizaje por refuerzo con retroalimentación humana). Técnica que usa preferencias de evaluadores humanos para orientar el comportamiento del modelo hacia respuestas más útiles y seguras.
- Modelo de difusión. Método usado sobre todo en generación de imágenes: el sistema aprende a partir de ruido aleatorio y lo va “limpiando” paso a paso hasta formar una imagen coherente con la instrucción.
- Alineamiento (alignment). Conjunto de métodos e investigación orientados a que el comportamiento de un sistema de IA corresponda a los valores e intenciones de quienes lo usan y de la sociedad.
Uso e interacción
- Prompt. La instrucción, pregunta o texto que se le da al modelo para obtener una respuesta.
- Ingeniería de prompts. Práctica de formular esas instrucciones de manera efectiva: dar contexto, ejemplos, formato deseado o pasos intermedios para mejorar el resultado.
- Ventana de contexto. Cantidad máxima de tokens que el modelo puede tener “a la vista” en una interacción, incluyendo tu mensaje, el historial y su propia respuesta.
- Temperatura. Parámetro que regula cuánta variabilidad hay en las respuestas. Valores bajos dan salidas más predecibles y repetibles; valores altos, más variadas y creativas.
- RAG (generación aumentada por recuperación). Técnica que conecta el modelo a una base de documentos: primero busca información relevante y luego responde apoyándose en ella, en vez de depender solo de lo memorizado.
- Agente de IA. Sistema que no solo responde, sino que planifica y ejecuta varios pasos usando herramientas externas (buscar en la web, escribir archivos, llamar a una API) para completar una tarea.
- Multimodal. Modelo capaz de trabajar con más de un tipo de dato a la vez, por ejemplo entender una imagen y describirla en texto.
Límites y riesgos
- Alucinación. Respuesta que suena plausible y bien redactada pero es falsa: citas inventadas, datos erróneos, fuentes inexistentes. Ocurre porque el modelo genera lo estadísticamente probable, no lo verificado.
- Sesgo algorítmico. Reproducción o amplificación, por parte del sistema, de prejuicios presentes en los datos de entrenamiento o en su diseño, lo que puede traducirse en resultados injustos para ciertos grupos.