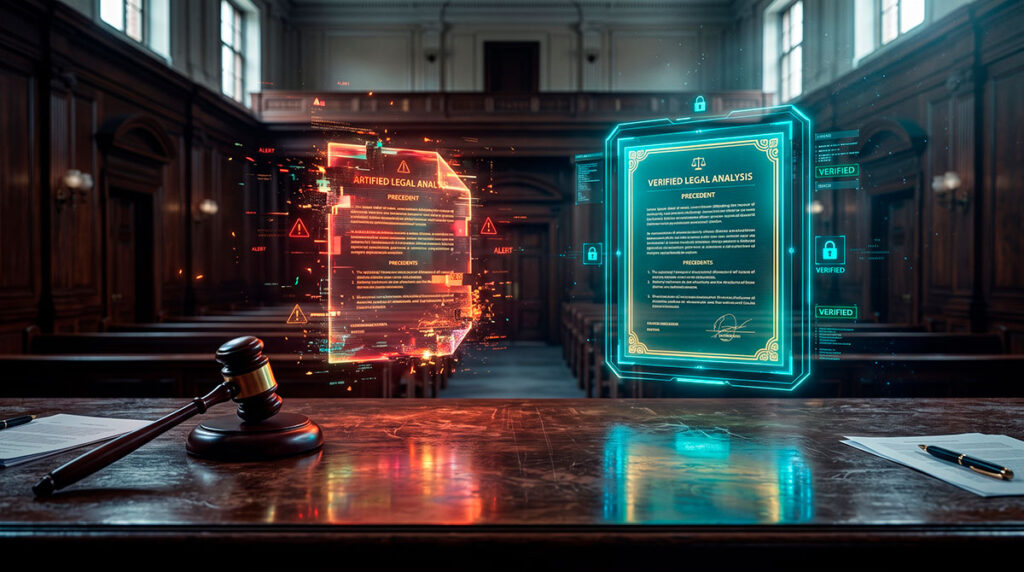

La incorporación de la Inteligencia Artificial en los tribunales de justicia y en el ejercicio de la abogacía ha dejado de ser un debate teórico para convertirse en una realidad operativa cotidiana. Mientras la sobrecarga de causas empuja a jueces, relatores y litigantes a buscar herramientas que optimicen los tiempos de tramitación, han comenzado a encenderse alarmas críticas en todo el mundo —y también en Latinoamérica— por un fenómeno tan riesgoso como evitable: la inclusión de jurisprudencia inexistente y errores de razonamiento en escritos y sentencias judiciales producto del mal uso de modelos generativos.
La línea que separa la eficiencia procesal de la negligencia jurídica no está en la tecnología misma, sino en la arquitectura y la metodología con que se despliega en el ecosistema judicial.
El “Mal Uso”: Cuando un chatbot generalista reemplaza el criterio jurídico
El error más grave y recurrente en el ámbito legal consiste en utilizar modelos de lenguaje públicos y de propósito general (como las versiones abiertas en la nube de ChatGPT, Claude o Gemini) como si fueran bases de datos jurídicas verificadas.
Un Modelo de Lenguaje Grande (LLM) tradicional no es un buscador de leyes: es un motor probabilístico entrenado para predecir la siguiente palabra más coherente en una oración. Cuando un abogado o funcionario judicial le pide a un modelo generalista “redacta un fallo citando jurisprudencia de la Corte Suprema sobre prescripción adquisitiva”, el sistema prioriza la fluidez gramatical por sobre la verdad fáctica.
Los 3 pecados capitales en la práctica judicial con IA:
- Alucinación de fallos y roles inexistentes: El modelo inventa números de rol, fechas, nombres de ministros y extractos de sentencias que suenan impecablemente redactados en jerga legal, pero que jamás existieron. Firmar una resolución o presentar un recurso con citas falsas sin verificar la fuente original destruye la fe pública y conlleva severas sanciones éticas y procesales.
- Contaminación con derecho extranjero: Al estar entrenados mayoritariamente con corpus legales anglosajones (Common Law) o españoles, los modelos sin ajuste local suelen mezclar figuras jurídicas foráneas que no existen o se aplican de forma opuesta en el Código Civil o Procesal chileno.
- Violación de la reserva y privacidad de las causas: Subir expedientes completos, declaraciones de testigos, datos de menores de edad o causas de familia a plataformas públicas en la nube vulnera el principio de confidencialidad y expone información sensible en servidores fuera de la jurisdicción nacional.
El “Buen Uso”: IA Local, RAG y Supervisión Humana
A pesar de estos riesgos, prohibir la Inteligencia Artificial en los tribunales o estudios jurídicos sería un retroceso histórico frente al volumen de causas acumuladas. El uso correcto de la tecnología en el Poder Judicial y en oficinas registrales se apoya en tres pilares técnicos innegociables:
[Expediente / Jurisprudencia Real] ──► [Entorno IA Local / RAG Cerrado] ──► [Borrador con Citas Trazables] ──► [Calificación y Firma Humana]
1. Arquitecturas RAG (Generación Aumentada por Recuperación) Cerradas
En lugar de preguntarle a la “memoria” del modelo, se implementa un sistema RAG conectado exclusivamente a un repositorio oficial de leyes vigentes, autos acordados y fallos reales de los tribunales superiores. Se configura el modelo con una temperatura cercana a cero (comportamiento determinista) para que solo pueda responder utilizando los documentos suministrados, obligándolo a entregar el enlace o la foja exacta de donde extrajo cada afirmación.
2. Procesamiento en Infraestructura Local (On-Premise)
Para resguardar el secreto de los expedientes, la revisión documental debe ejecutarse en servidores locales dentro de la misma institución (utilizando motores como Ollama o LM Studio sobre GPUs dedicadas con modelos de pesos abiertos como Gemma o Llama). De esta forma, ningún RUT, domicilio o antecedente penal sale a internet.
3. Tareas de Asistencia, nunca de Decisión Jurisdiccional
El buen uso de la IA en la justicia se enfoca en despejar el trabajo mecánico para liberar tiempo de análisis humano:
- Resumen cronológico de expedientes extensos: Procesar tomos de cientos de páginas para extraer una línea de tiempo clara de los hechos probados y las pruebas rendidas.
- Anonimización automática de sentencias: Detectar y ocultar automáticamente nombres, RUTs y direcciones en los fallos antes de su publicación pública para proteger los datos personales de los intervinientes.
- Control formal de admisibilidad: Verificar en segundos si una presentación cumple con los plazos legales, patrocinio de abogado, pago de tasas o documentos adjuntos obligatorios antes de pasar al despacho del juez.
Comparativa: Práctica Riesgosa vs. Estándar Profesional
| Dimensión | Mal Uso (Riesgo Judicial) | Buen Uso (Estándar LegalTech) |
| Fuente de Datos | Memoria abierta del LLM en internet. | Base documental cerrada y verificada (RAG). |
| Privacidad | Nube pública gratuita (datos expuestos). | Servidor local (On-Premise) o nube soberana aislada. |
| Jurisprudencia | Petición directa de citas (riesgo de alucinación). | Búsqueda semántica sobre fallos reales indexados. |
| Rol del Juez / Abogado | Copiar y pegar sin contrastar las fuentes. | Auditoría crítica (Human-in-the-loop) y calificación final. |
El veredicto: La responsabilidad no se delega
La Inteligencia Artificial es el asistente de investigación y gestión documental más potente que ha tenido el sector jurídico en su historia, pero carece de conciencia, ética y comprensión de la equidad. Un algoritmo puede cruzar mil fojas en tres segundos para encontrar una contradicción en un contrato o resumir las alegaciones de las partes, pero la ponderación de la prueba, la interpretación de la ley y el acto de dictar justicia siguen siendo facultades exclusivamente humanas. Cuando un fallo contiene un error generado por IA, la equivocación nunca es de la máquina: es del profesional que renunció a su deber de revisar antes de firmar.