
Para una institución pública, un centro de salud o una oficina de servicios registrales, un corte de internet no significa simplemente perder acceso al correo electrónico: significa la parálisis total de la atención ciudadana, el bloqueo de firmas electrónicas avanzadas y la interrupción de consultas a bases de datos centrales. Aunque la llegada de la fibra óptica ha mejorado la estabilidad general, la regla de oro de la administración de sistemas sigue siendo la misma: un solo enlace es un punto único de falla (Single Point of Failure).
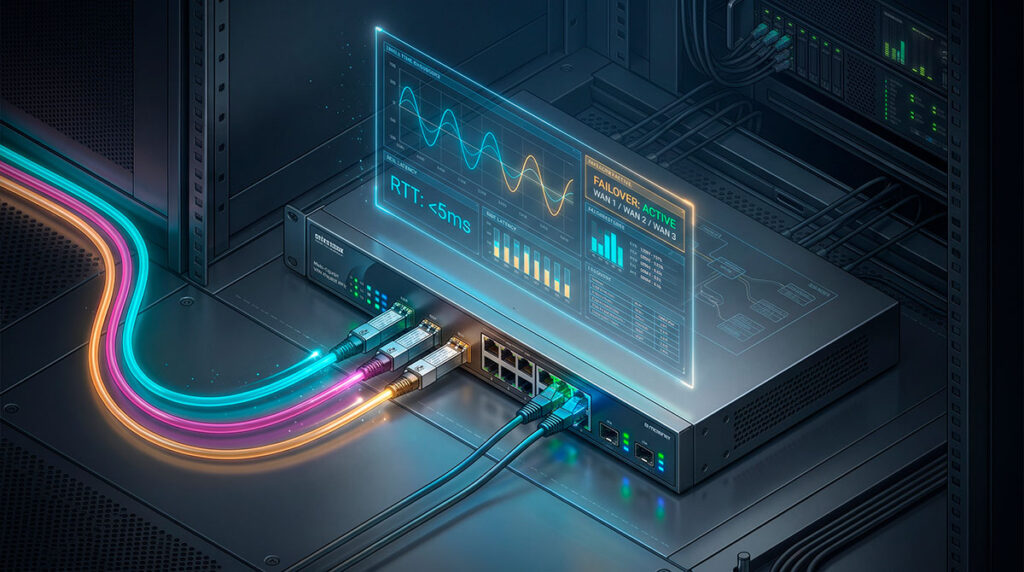
La respuesta estándar en ingeniería de redes ha sido implementar arquitecturas Multi-WAN mediante routers empresariales multi-gigabit que agrupan dos o tres conexiones simultáneas de diferentes proveedores (ISP). Sin embargo, la verdadera evolución en 2026 radica en la capa de supervisión: sustituir las reglas estáticas de conmutación por error (failover) por agentes de IA ligeros para el monitoreo predictivo del tráfico.
El límite del Failover tradicional vs. Detección Inteligente
El mecanismo clásico de tolerancia a fallos en un router balanceador se basa en pings periódicos a servidores DNS públicos. Si un enlace deja de responder durante 10 segundos, el tráfico se conmuta a la línea secundaria.
Este enfoque tiene dos debilidades críticas en entornos con alta demanda de datos y atención en tiempo real:
- La “caída silenciosa” (Brownout): El enlace no está completamente muerto, pero sufre una pérdida de paquetes del 15% y una latencia que escala de 10 ms a 400 ms. Para un script de ping básico la línea sigue viva, pero los sistemas de turnos, las colas de sockets y las videollamadas colapsan.
- Saturación por asimetría: Cuando múltiples terminales de atención y servidores locales consultan modelos de IA o transfieren matrices documentales pesadas, un balanceo de carga ciego puede saturar el enlace más lento mientras el más rápido permanece subutilizado.
[ISP 1: Fibra Principal 1 Gbps] ──┐
[ISP 2: Enlace Secundario 1 Gbps] ─┼──► [Router Multi-WAN / Balanceador] ──► [Agente IA de Métricas] ──► Conmutación Predictiva
[ISP 3: Respaldo Dedicado 1 Gbps] ─┘
Implementación de AIOps en el Borde de la Red
Al conectar la telemetría del router (mediante protocolos como SNMP o APIs de controladores de red) a un contenedor local ligero que ejecute un modelo de series temporales, la gestión de la red adquiere capacidades predictivas:
- Predicción de degradación por jitter: El algoritmo detecta micro-variaciones en la fluctuación de fase (jitter) y el tiempo de respuesta antes de que se produzca una desconexión total, redirigiendo el tráfico transaccional crítico (APIs de firma y validación de identidad) al enlace más limpio de forma preventiva.
- Priorización dinámica de cargas de trabajo: Si el sistema detecta que la oficina está procesando una tanda masiva de documentos mediante OCR o sincronizando réplicas de bases de datos, asigna temporalmente un enlace completo y exclusivo a esa tarea, protegiendo el ancho de banda destinado a los tótems de atención presencial y las pantallas de turnos.
- Aislamiento de cuellos de botella: Ante un incidente de lentitud, la IA correlaciona en segundos si la falla proviene del proveedor de telecomunicaciones externo, de un bucle en la red interna o de un pico de consumo en un equipo específico, entregando un diagnóstico exacto al administrador de infraestructura.
La redundancia física de enlaces ya no es suficiente por sí sola; dotar a la infraestructura de red de un criterio analítico continuo es lo que garantiza una operación verdaderamente ininterrumpida.